APIShare:一个 Key 用全部模型,把分享的 Token 摆在明面上
APIShare:一个 Key 用全部模型,把分享的 Token 摆在明面上
星染我手上攒了几个模型服务的 Key,一直想分给朋友用。最开始当然是用 new-api,社区里做这件事的标准答案。折腾了一年我放弃了,自己写了一个:APIShare。
不是 new-api 不好。它是给「中转站」设计的:有渠道、有用户、有分组、有充值。我要的只是「我有额度,分给几个朋友」,范围窄得多。
1. 我用 new-api 卡在哪
1.1 朋友得先注册,再配渠道
new-api 的模型是「用户 → 令牌 → 渠道」。朋友拿到地址之后,得先注册、再领令牌,如果他自己还要接别的服务,还得继续配渠道、配模型映射、配分组。
我朋友里有一半人根本不想理解「渠道」是什么。他们只想知道地址填哪、Key 填哪。
配完也不一定好用。new-api 其实是支持协议转换的,OpenAI 和 Claude Messages 能双向转,OpenAI 转 Gemini 也行,这点不能冤枉它。问题是它没有「原生格式优先」这个逻辑:同一个模型要是同时挂了一条 OpenAI 渠道和一条 Anthropic 渠道,你的 OpenAI 请求有可能被送到需要转换的那条上。而转换只覆盖主干,边上就容易翻车。官方 issue 里有人贴过 Gemini 方向「纯文本可以,function calling 还不支持」,也有人转完之后 tools 变 null 直接 400。最后全变成我看不懂的报错,绕一圈还得我回来排查。
1.2 渠道挂了,请求还在往上撞
调度这块 new-api 纸面上什么都不缺:权重、优先级、失败重试、渠道亲和都有。我一个长会话聊一晚上也开着亲和,头几天挺舒服。
难受的是它坏掉之后的行为。
一条渠道不可用了,不管是限流、Key 失效还是上游抽风,请求不会爽快地换走,会继续往那条上撞。开了亲和更明显,亲和规则本身就要求锁在这条渠道上,失败了也不重试。官方 issue 里说得挺直白:想让它重试,得去亲和规则的高级设置里把「失败后不重试」关掉。
自动禁用呢?有,但默认只对 401 生效,429 和 5xx 不触发。禁用之后重试的下标还会错位,一跳就跳过了下一优先级。想让它恢复,还得靠「渠道自动测试」,这个东西默认是关的。
于是就成了这样:我明明配了备用渠道,朋友那边还是一直报错,一直到我手动进后台把坏的那条点掉。我不想要更多开关,我只想失败就立刻换一条,坏的那条自己歇着,好了自己回来。
1.3 稳定性我看不见
上游挂了、某个 Key 被限流了、某个模型今天特别慢,这些我在 new-api 里找不到一个地方能一眼看出来。等朋友来问「是不是你那个服务挂了」,我才去翻日志。
我想看的就一件事:每个模型现在到底能不能用,成功率多少,快不快。
1.4 分享了多少 Token,我说不出来
这个需求有点私人。我想在博客或者群里贴个页面,说「这个月我一共给大家分享了 X 亿 Token」。
new-api 的统计是给运营看的:渠道消耗、用户充值、今日收入。不是不能算,是不直观。我要的是一个大数字,下面一条趋势线,再排一下哪些模型用得最多,最好朋友自己粘个 Key 就能查还剩多少额度,不用来问我。
2. 我想要的东西
一个 Key 能用全部模型,模型列表对客户端是统一的,背后挂几条上游、几把 Key,客户端不用知道。朋友只填 URL 和 Key,不管他用 Claude Code、Codex、Gemini CLI 还是随手写个 Python 脚本,都能直接跑。最后是我能看见分享了多少,全站累计、每日趋势、各模型用量、每个人消耗了多少,摆在一个公开页面上。
这三件事分别是路由、协议和可观测性的问题。分开说。
3. 问题一:一个 Key 怎么用上全部模型
3.1 上游是可叠加的
网关里可以挂任意多条上游,每条有类型、Key、代理、模型白名单:
openai(Chat 或 Responses 协议)、anthropic、gemini—— 常规的cliproxy—— 内置 CLIProxyAPI SDK,OAuth 订阅账号池,不用另装
客户端看到的是一份合并后的模型列表。它请求 claude-sonnet,网关决定这条请求该发给谁。
模型白名单留空就是允许全部;要限制某个上游只接某几个模型,就填进去。还可以做模型映射:客户端请求 chat-fast,上游实际收到 deepseek-chat。这个在「朋友想用便宜模型」的场景很好使——我给他一个名字,他自己不用操心背后是谁。
3.2 调度:优先级 → 权重 → 会话粘性
pickUpstream 的顺序我改过好几版,现在是:
- 优先级(priority):数字越小越优先。0 是主力,1 是备用,2 是应急。低层只在高层全不可用时才接
- 格式与白名单层级:原生格式 + 显式白名单 > 转换格式 + 显式白名单 > 原生 + 通配符 > 转换 + 通配符
- 权重(weight):同层内加权随机,权重 0 不参与调度
- 会话粘性:同一会话在 TTL 内保持原上游
第 4 条不是 new-api 没做过的事。渠道亲和它早就有,Key 级别的后来也补上了。差别在亲和失败之后怎么办:那边锁住了就不动,这边亲和只决定选谁,选中的那条一开始失败,请求立刻脱开去换,冷却的是那一把 Key,不是整条上游。
难的是「会话」这个概念各家定义不一样:
| 客户端 | 会话标识从哪来 |
|---|---|
| Cline | 请求体 session_id / conversation_id,再退 X-Task-ID / X-Session-Id |
| Codex | session_id / conversation_id 头 |
| Claude Code | metadata.user_id 里的 _session_<uuid> |
| OpenCode | OpenCode 会话头、x-opencode-request |
都捞不到,就退化成「首条用户消息指纹」。不完美,但至少不会一秒换一个上游。
3.3 失败只冷却当次的 Key
这条规则听起来很细节,但它决定了「一个人被限流,会不会把所有人一起拖下水」。
401 / 403 / 408 / 429 / 5xx / 529 和网络错误都算失败,但冷却的是这个 Key,不是整条上游:首次 30 秒,指数延长到最多 10 分钟,同时听上游的 Retry-After。在重试预算内先换同供应商的其他 Key,并把会话重新绑过去;实在不行才按优先级换供应商。
一个 Key 挂了就判整条上游死刑,是这类网关最容易犯的错。
3.4 稳定性要能看见
这是 new-api 让我最难受的地方,所以单独做了一页「模型总览」:
页面上一眼能看到每个模型的状态(idle / operational / incident,有故障的排前面)、滚动 24 小时的成功率、平均 TPS(输出 Token 除以实际生成时间,没有有效样本就显示「—」,不编速度),以及这个模型现在有哪几条上游能接、各自的成功率、是不是在冷却。最后一行是最后一次调用的状态码和时间。
只统计「当前可路由」的上游——被禁用的、权重为 0 的、已下线的都不算,所以页面上的每个数字都描述的是现在。
还有一个模型测试按钮:直接拿一条上游打一次真实请求,返回延迟、回复内容、输入输出 Token、错误信息(Key 会打码)。不用等朋友来报错,我自己先点一下就知道。
4. 朋友只填 URL + Key
这一节的目的就一个:让朋友不用理解任何东西。四种协议随便进、随便出,中间我来翻译。
| 客户端 | 它说的是 | 我的上游可能是 |
|---|---|---|
| Claude Code | Anthropic Messages | OpenAI Chat |
| Codex CLI | OpenAI Responses | 任意 |
| Gemini CLI | Gemini | OpenAI Chat |
| OpenAI SDK | Chat Completions | Anthropic / Gemini |
翻译里真正会卡住人的是这几处:
推理档位。Chat 叫 reasoning_effort,Responses 叫 reasoning.effort,Claude 叫 output_config.effort,还有上游只认固定预算。得双向映射,并按上游实际支持的档位近似(往 DeepSeek 转时 xhigh 落到 max、medium 落到 high)。近似就是近似,不保证 Token 数一致,但不会把「深思」翻译成「随便想想」。
工具调用。Codex 的 apply_patch 是自由文本工具,换格式就没地方放,得先打包成标准函数参数,回来再还原成 custom_tool_call。这里最怕「参数不完整却发了个成功结束」——客户端会以为工具跑完了,把同一个补丁再执行一遍。
断流。第一个字吐出来之前挂了,偷偷换一个,用户无感;已经开始输出了再挂,绝不重放——重放就是让用户看着同一段话出现两次。这条规则一句话,实现起来是整条流式链路的分水岭。
系统指令。Claude Code 有时把纯文本 role: "system" 塞进 messages[],得识别出来合并回系统指令,否则会话指纹全乱。
所以中间抽了一层:入站解析成内部表示 → 路由和鉴权 → 按目标格式组装 → 逆向往回拼、重塑事件流 → 按客户端原生规范推 SSE。
对朋友来说,这一切都不存在。他看到的只有:地址 + Key。
5. 问题三:把分享的 Token 摆在明面上
这部分是我最想要的,也是 new-api 最不直观的。
5.1 一个公开页面
网关自带一个公开首页(/api/public/overview,不暴露任何凭据和余额,只有全站遥测),上面有: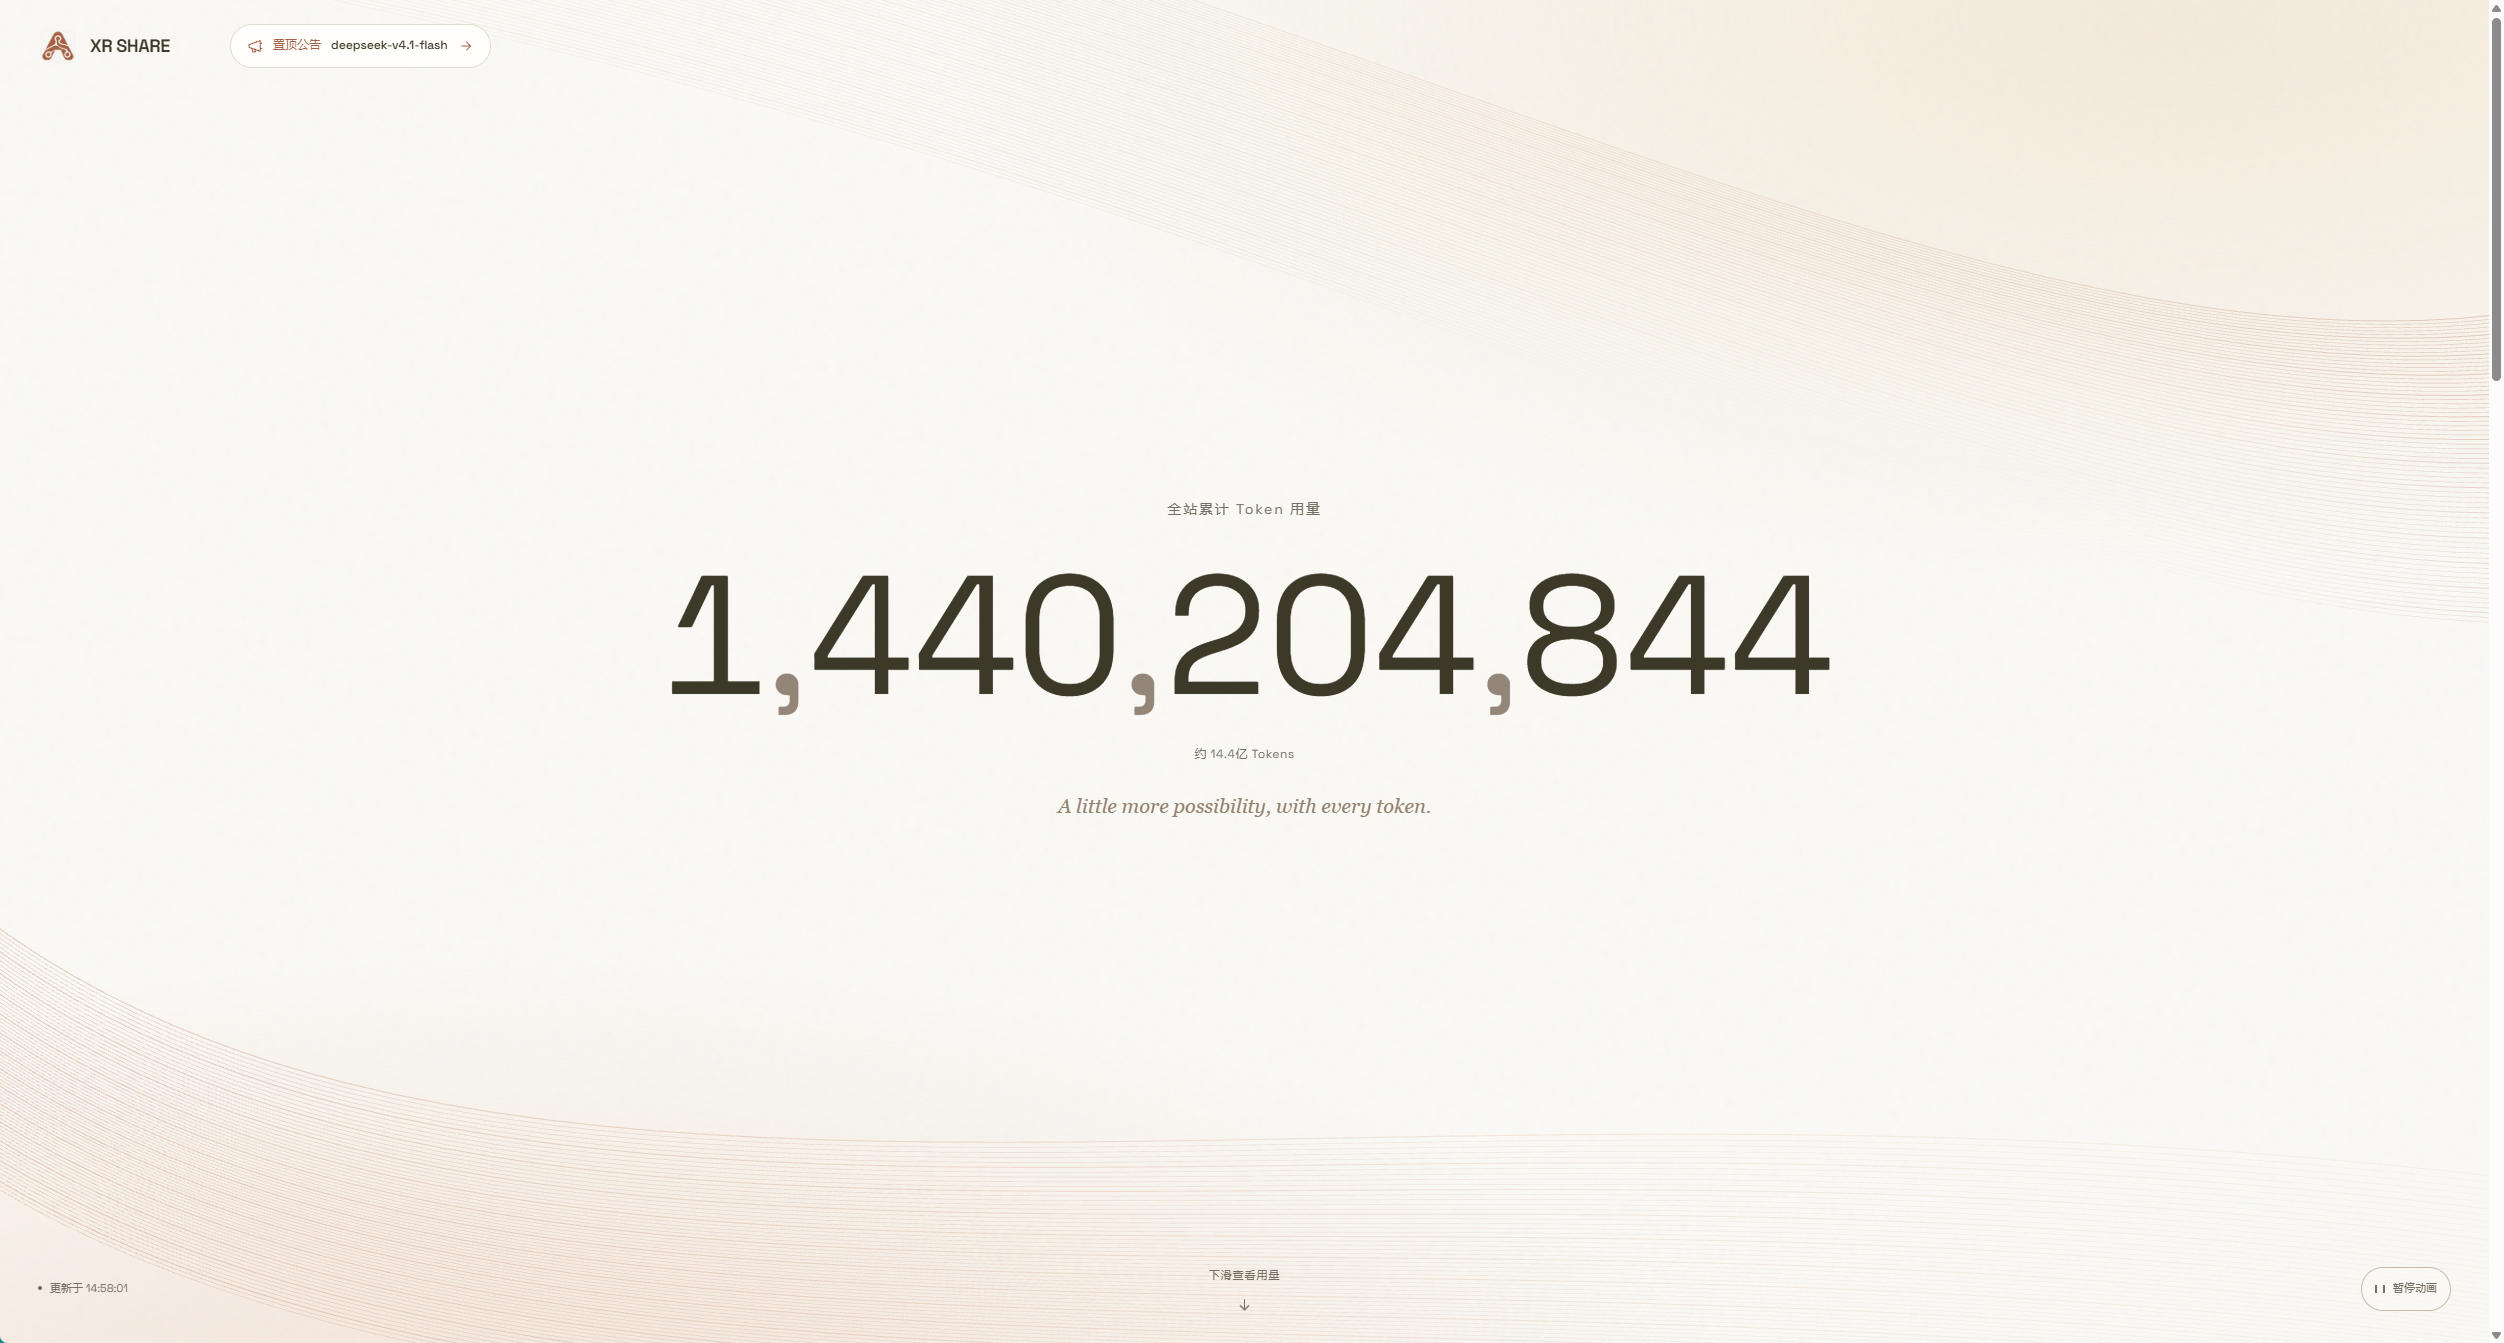
最上面是全站累计 Token 用量,输入加输出。下面一周七天的调用足迹,可以在「调用次数」和「Token 用量」之间切。再往下按调用次数给模型排队,每个模型标 Uptime 和累计用量,图例分调用成功、部分失败、调用失败、无调用四种,Uptime 按真实请求加权算。最底下是公告区和额度查询,朋友粘个 sk-... 就能看还剩多少,省得来问我。
5.2 后台看得更细
管理端的看板是另一套,按北京时间、滚动 24 小时:
看板按北京时间、滚动 24 小时算。RPM 走 5 分钟窗口,免得每秒在 0 和 1 之间跳。今日花费和请求数都会跟昨天同一时刻比一下。另外还有 24 小时的成功率,最近一分钟和一小时的 TPM、错误率、P50,cache_read 占读加写加输入的比例,以及按 Key、模型、上游各取前 12 的用量排行。
计费按 LiteLLM 价格库走,启动时同步、每天自动刷新,也支持手动覆盖。每次请求都会把「用的什么价、花了多少钱」做成快照存进日志,扣费和日志在同一个事务里提交。
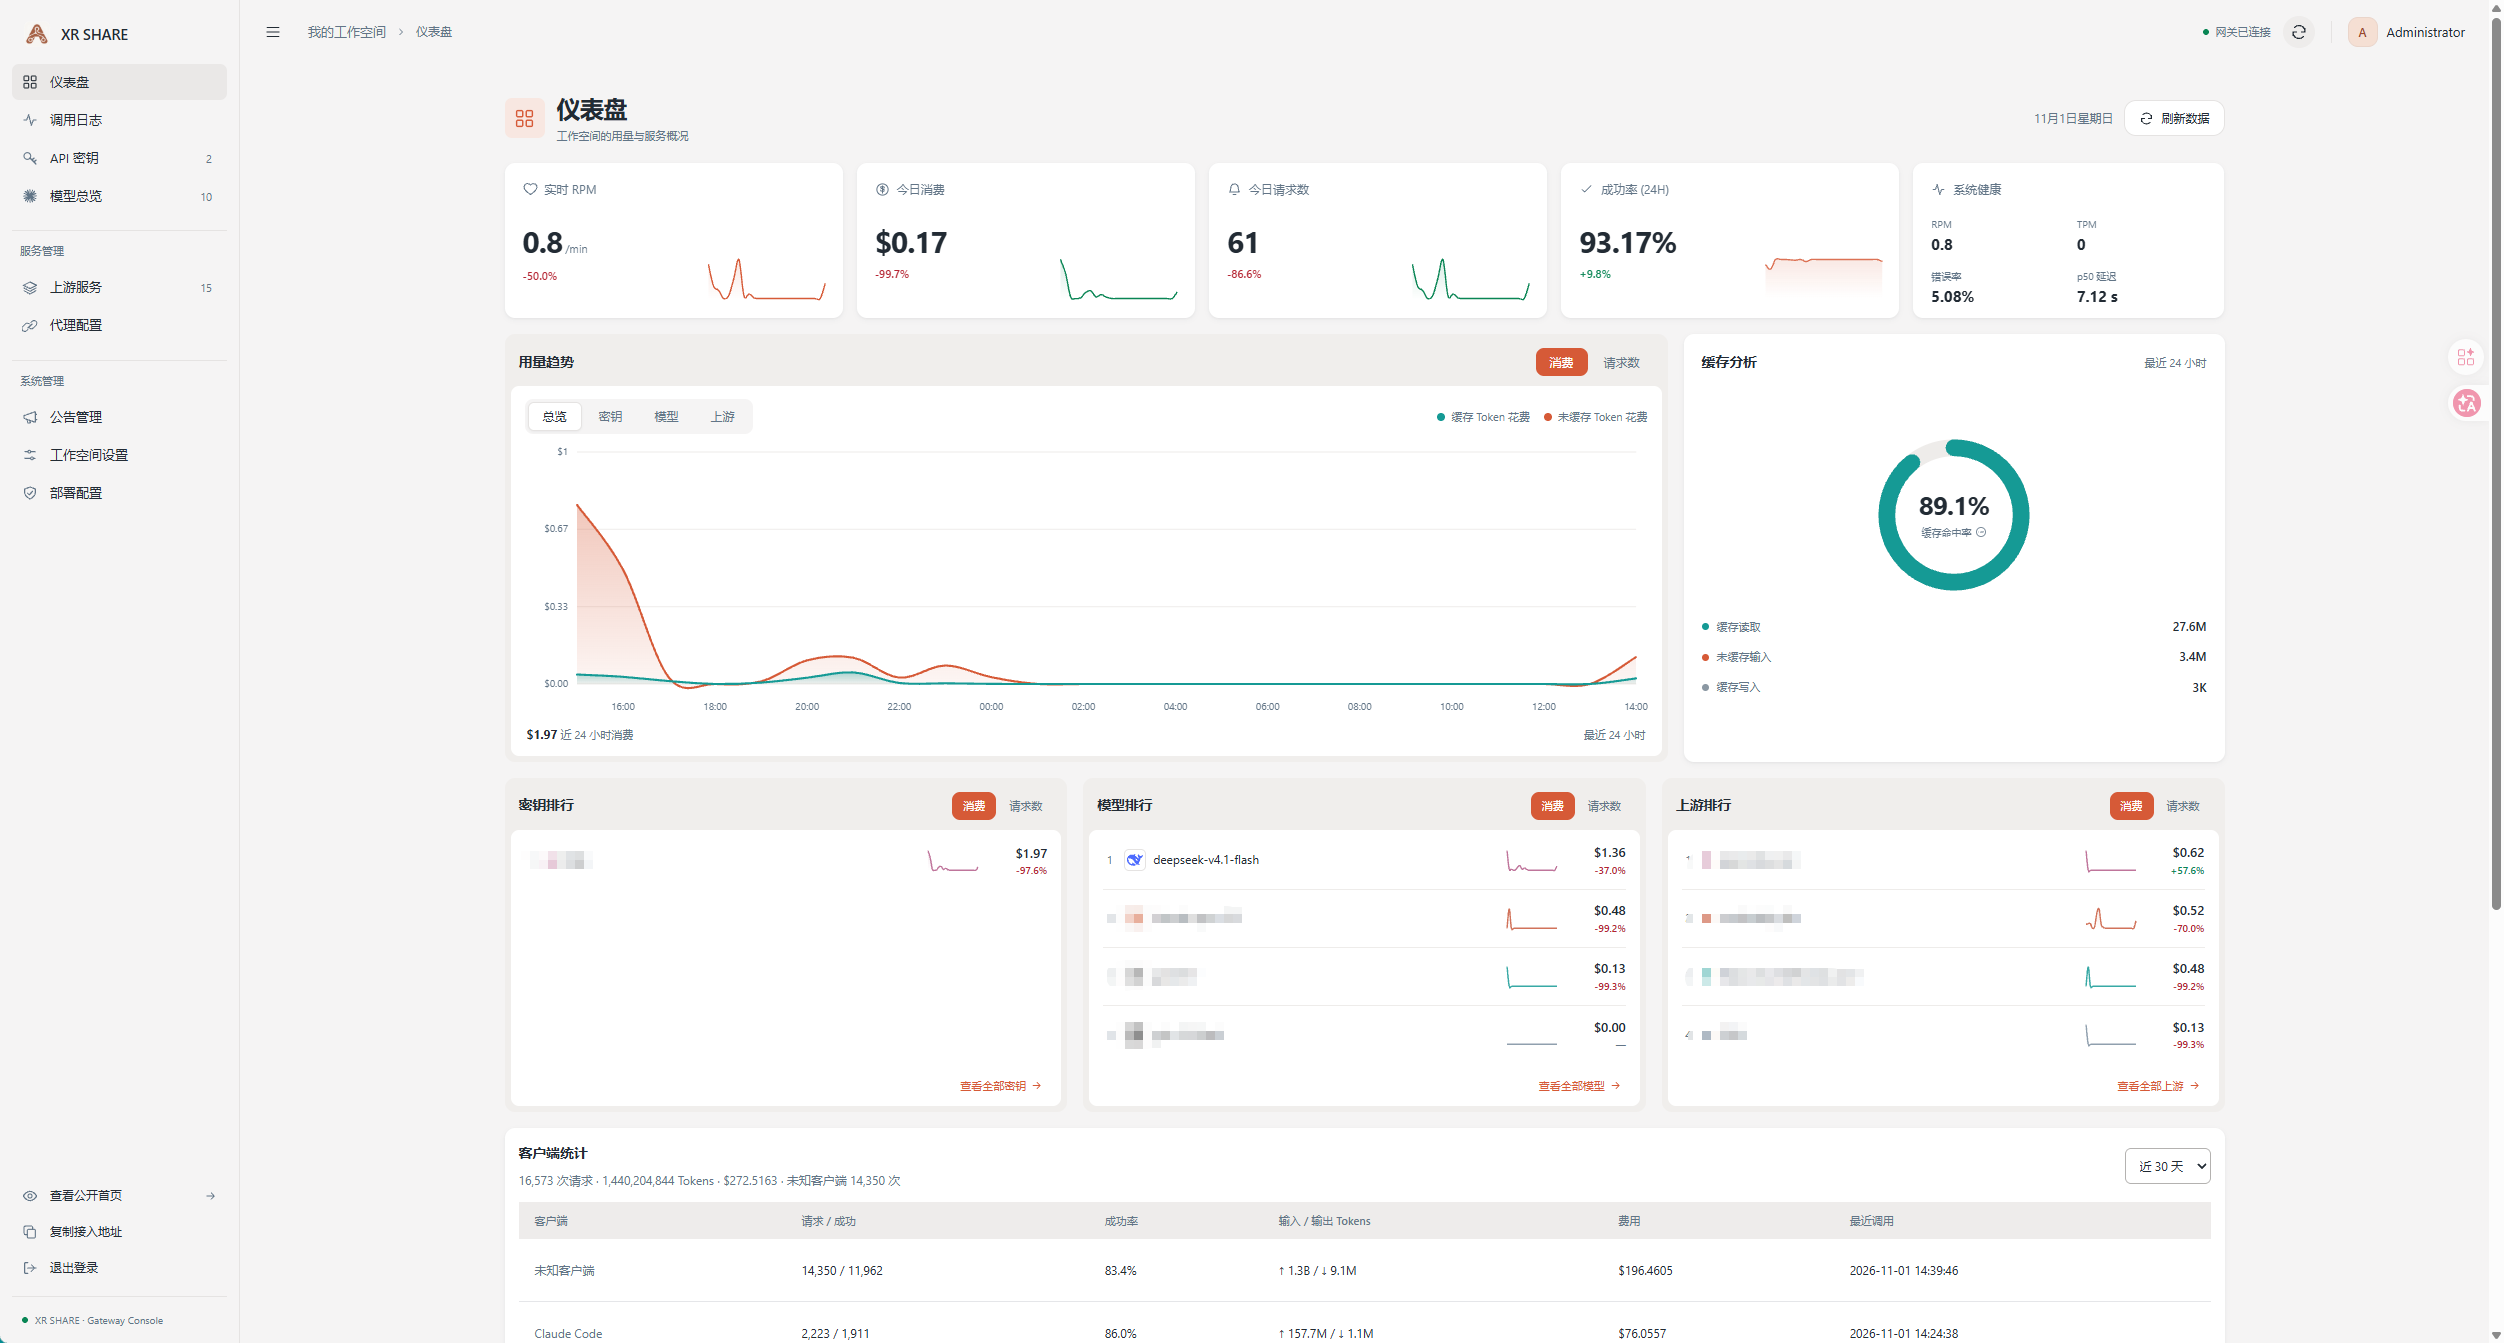
个人分享场景,价格准到小数点后几位没意义,但能看出今晚谁烧了多少钱非常有意义——这是我第一周最需要的东西。
5.3 日志保留 7 天,但累计数据不丢
调用日志默认保留 7 天后清理,但清理前会把「调用次数、成功数、Token、费用、最后调用时间」按「北京时间日期 × 模型」聚合进 call_log_daily。所以日志可以删,统计不能丢。这是我特 意要求的:分享这件事,看的是长期累计,不是今天这一屏。
6. 每人一个 Key,各自的限额
分享给人最怕的是「一个人的脚本把所有人的额度烧完」,所以每个 Key 独立:QPS、并发上限、共享额度、贵模型单独限额、模型白名单、一键禁用。额度为 0 表示不限。